CERN攜手Mistral打造「大型物理模型」 讓AI讀懂數十億次粒子碰撞
Flare計畫要訓練可支援事件重建、粒子辨識與異常搜尋的基礎模型,為高亮度大型強子對撞機倍增資料量提前準備。
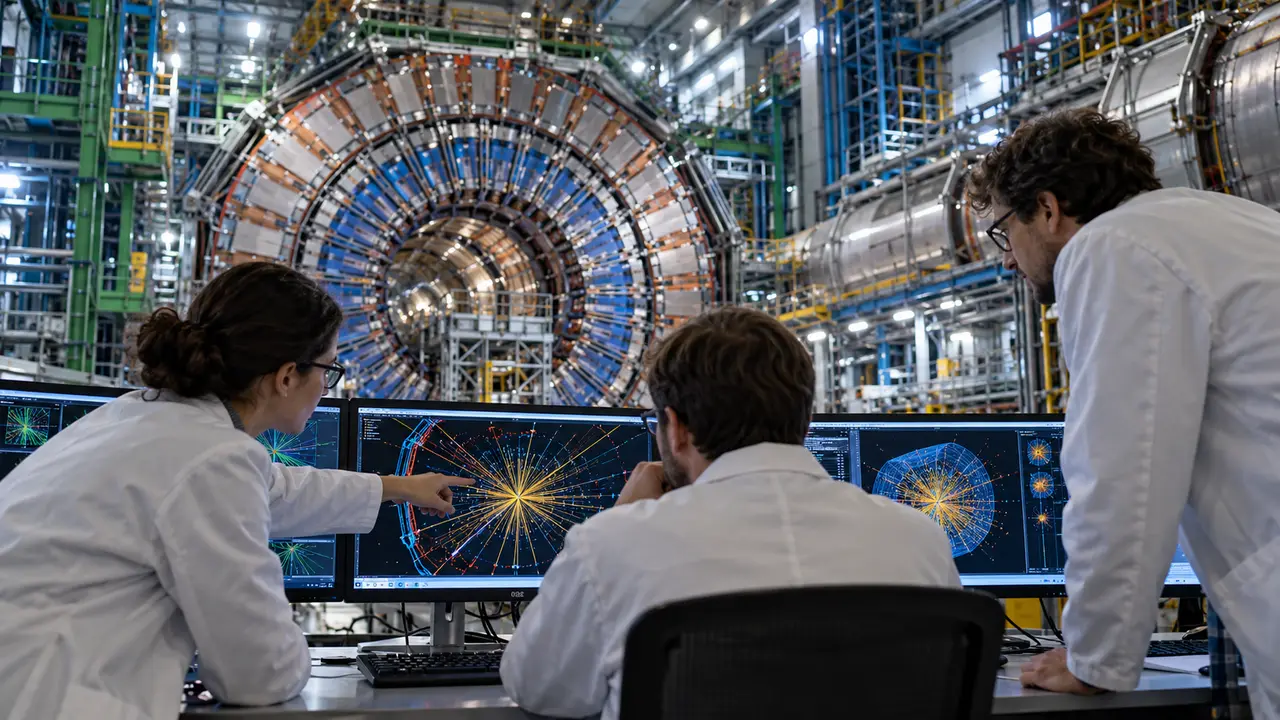
歐洲核子研究組織CERN與法國人工智慧公司Mistral宣布合作推動Flare計畫,目標是建立可處理粒子碰撞資料的「大型物理模型」。團隊將以數十億次模擬質子碰撞訓練基礎模型,讓同一套系統支援事件重建、粒子辨識、異常訊號搜尋與偵測器設計,而不是每一項任務都從零開始。
大型強子對撞機每秒產生龐大訊號,真正寫入儲存系統前就必須經過觸發與篩選。研究人員再從能量沉積、粒子軌跡和時間資訊重建碰撞事件,找出極少數可能對應新物理的模式。資料量越大,傳統逐步處理的計算成本越高,AI若能學會跨偵測器的共同結構,可能加快分析。
這裡的「大型模型」和生成聊天文字的模型並不相同。訓練資料不是網頁語句,而是粒子物理模擬、偵測器訊號與已知定律約束;輸出也不是流暢回答,而是粒子種類、動量、事件分類或異常分數。名稱相似容易吸引注意,真正成敗仍取決於物理精度、誤差和可驗證性。
CERN累積資料規模已接近艾位元組等級,約相當於十億GB。高亮度大型強子對撞機預計在2030年前後進一步提升碰撞量,部分資料率可能增加約十倍。硬體升級若沒有同步改善篩選、儲存與分析方法,更多碰撞只會變成更大的計算負擔,不會自動產生更多發現。
基礎模型的吸引力在於可重複使用。模型先從大量模擬學到碰撞事件的一般表示,再針對特定實驗或研究問題微調,理論上能減少每個團隊各自訓練的成本。這種做法若成功,也可讓較小研究團隊使用共享能力,不必擁有和大型合作組織相同的算力。
最大風險來自模擬與真實世界的落差。模型在模擬資料上表現很好,不代表能正確處理偵測器老化、校準誤差或未被模擬涵蓋的現象。更棘手的是,搜尋未知粒子本來就要找出不符合既有預期的訊號;若模型過度學習模擬假設,可能把真正的新物理當成雜訊排除。
因此物理模型不能只用準確率評分。研究人員需要知道誤判集中在哪裡、輸出如何隨偵測器條件改變,以及統計不確定性如何傳到最終結果。可重現的訓練流程、獨立驗證和資料版本紀錄,比展示單一漂亮指標更重要。科學發現必須能被其他團隊檢查,黑箱速度不能取代證據。
Mistral將提供模型與工程能力,CERN提供粒子物理資料、計算環境和科學驗證。雙方尚未公布完整預算與交付時程,合作仍處於建立技術路線的階段。大型模型需要大量加速器與電力,若節省的分析成本小於訓練支出,計畫就難以擴張;算力效率將和物理表現同樣重要。
資料治理也是核心。CERN長期推動開放科學,但原始碰撞資料、模擬軟體與實驗合作規則十分複雜。模型權利、研究者存取、商業再利用和安全限制若沒有先說清楚,公部門科學資料可能成為單一公司的競爭資產。合作成果是否開放給全球研究社群,將影響它對科學的公共價值。
AI不會取代理論物理學家提出問題,也不能自行把異常宣布成新粒子。它更像一套新的顯微鏡與篩網:可以提高人類看見微弱訊號的機會,也可能因校準錯誤製造假象。研究人員仍要用統計檢驗、不同衰變通道和獨立實驗反覆確認,才能把模型提示變成科學結論。
Flare計畫的真正意義,不在替AI再添一個華麗名稱,而在為下一代碰撞資料建立可驗證的共同工具。高亮度對撞機將把人類推向前所未有的資料規模,分析方法若沒有同步進化,昂貴實驗的資訊會埋在雜訊裡。CERN與Mistral必須證明,模型不只更快,還能在不確定性、透明度與開放性上符合科學標準。